EN


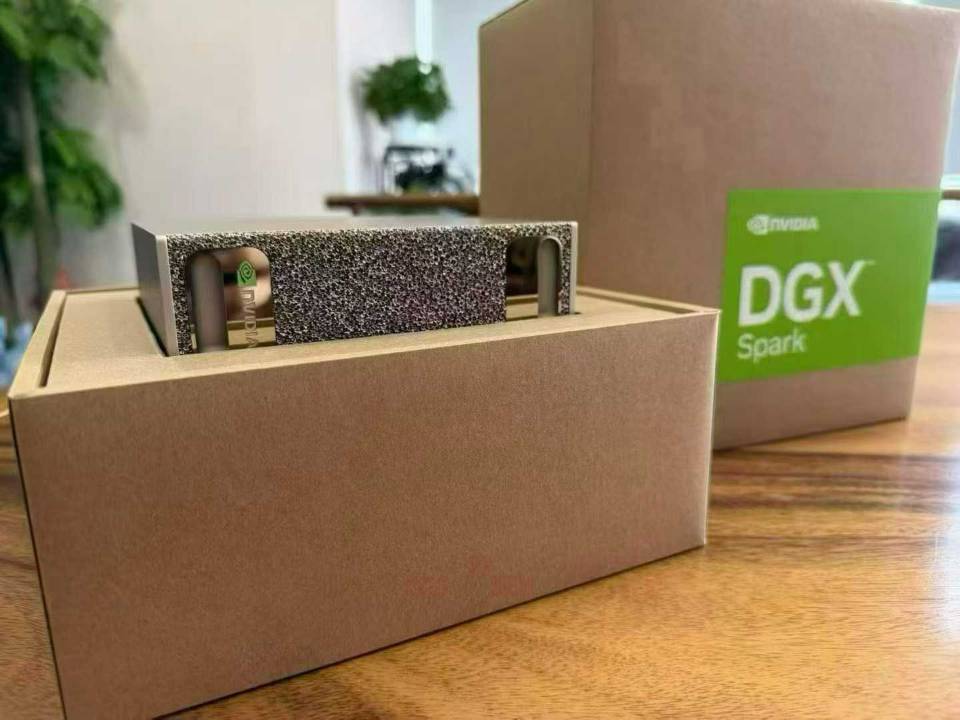
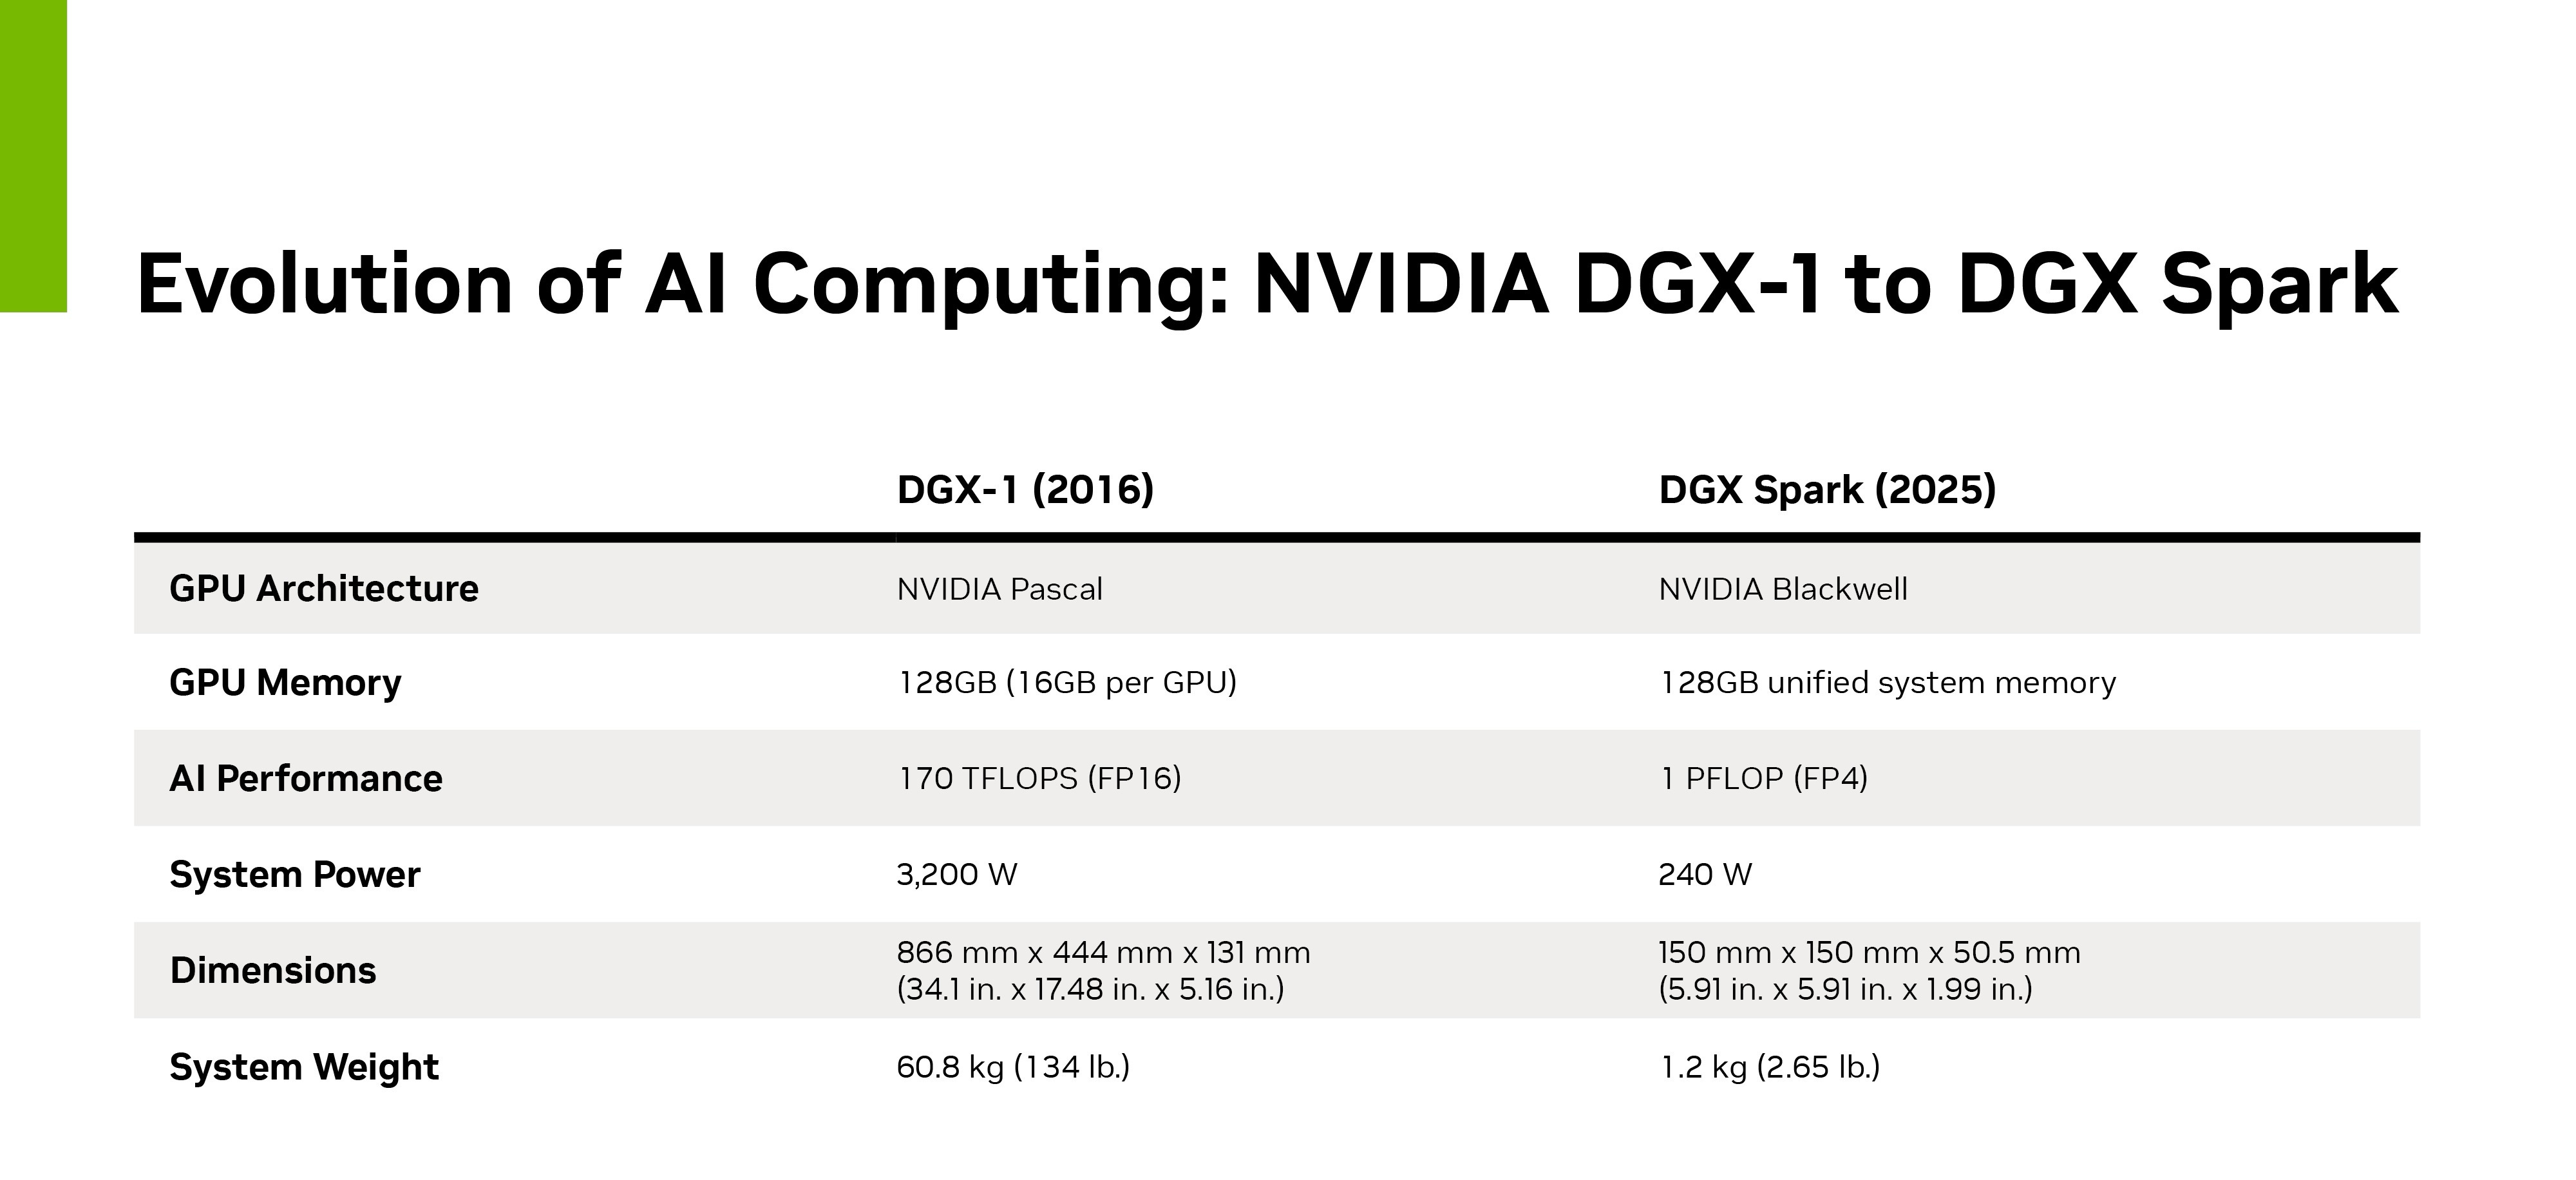
ซูเปอร์คอมพิวเตอร์ปัญญาประดิษฐ์ NVIDIA DGX Spark — GB10 Grace Blackwell, หน่วยความจำรวม 128 GB, NVMe 4 TB, ประสิทธิภาพการคำนวณ 1 PFLOP ที่ความแม่นยำ FP4
ซูเปอร์ชิป: ชิปซูเปอร์ชิป NVIDIA GB10 Grace Blackwell
ซีพียู: cPU แบบ Arm 20 คอร์ (10 × Cortex-X925 + 10 × Cortex-A725)
GPU: หน่วยประมวลผลกราฟิกแบล็กเวลล์พร้อมคอร์เทนเซอร์รุ่นที่ 5 ให้ประสิทธิภาพสูงสุดถึง 1 พีเฟลอปที่ความแม่นยำ FP4
ความจํา: หน่วยความจำรวมแบบสอดคล้อง 128 กิกะไบต์ ใช้ LPDDR5x แบบ 256 บิต ที่ความเร็ว 273 กิกะไบต์ต่อวินาที
- ภาพรวม
- สินค้าที่แนะนำ
คุณสมบัติหลัก
NVIDIA GB10 Grace Blackwell Superchip — หน่วยประมวลผลกลางแบบ 20 คอร์ (10× Cortex-X925 + 10× Cortex-A725) คู่กับหน่วยประมวลผลกราฟิกแบบ Blackwell ที่ให้ประสิทธิภาพสูงสุดถึง 1 PFLOP ที่ความแม่นยำระดับ FP4
หน่วยความจำรวมแบบสอดคล้องกัน 128 กิกะไบต์ — แรม LPDDR5x 256 บิต ที่ความเร็ว 273 GB/วินาที; รัน ปรับแต่ง และให้บริการโมเดลที่มีพารามิเตอร์สูงสุด 200,000 ล้านตัวได้ในเครื่อง
หน่วยจัดเก็บข้อมูล NVMe M.2 ความจุ 4 เทระไบต์ พร้อมระบบเข้ารหัสภายในตัว ติดตั้งระบบปฏิบัติการ NVIDIA DGX OS และชุดซอฟต์แวร์ AI แบบเต็มรูปแบบของ NVIDIA มาให้แล้ว
ขยายระบบเมื่อคุณต้องการเพิ่มประสิทธิภาพ — ระบบเครือข่าย NVIDIA ConnectX-7 (ความเร็ว 200 Gb/วินาที พร้อมพอร์ต QSFP จำนวน 2 ช่อง) พร้อมพอร์ต 10 GbE และ Wi-Fi 7; สามารถเชื่อมคลัสเตอร์ได้สูงสุด 4 หน่วย เพื่อประมวลผลโมเดลที่มีพารามิเตอร์สูงสุด 700,000 ล้านตัว
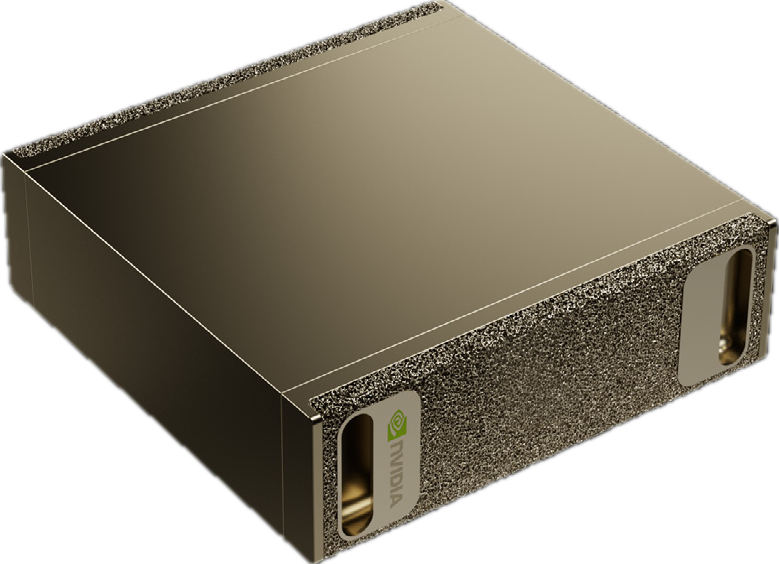
ขนาดเท่าเดสก์ท็อปจริง — ขนาด 150 × 150 × 50.5 มิลลิเมตร น้ำหนัก 1.2 กิโลกรัม ใช้แหล่งจ่ายไฟภายนอกเพียงหนึ่งตัวที่ให้กำลัง 240 วัตต์
คำอธิบาย
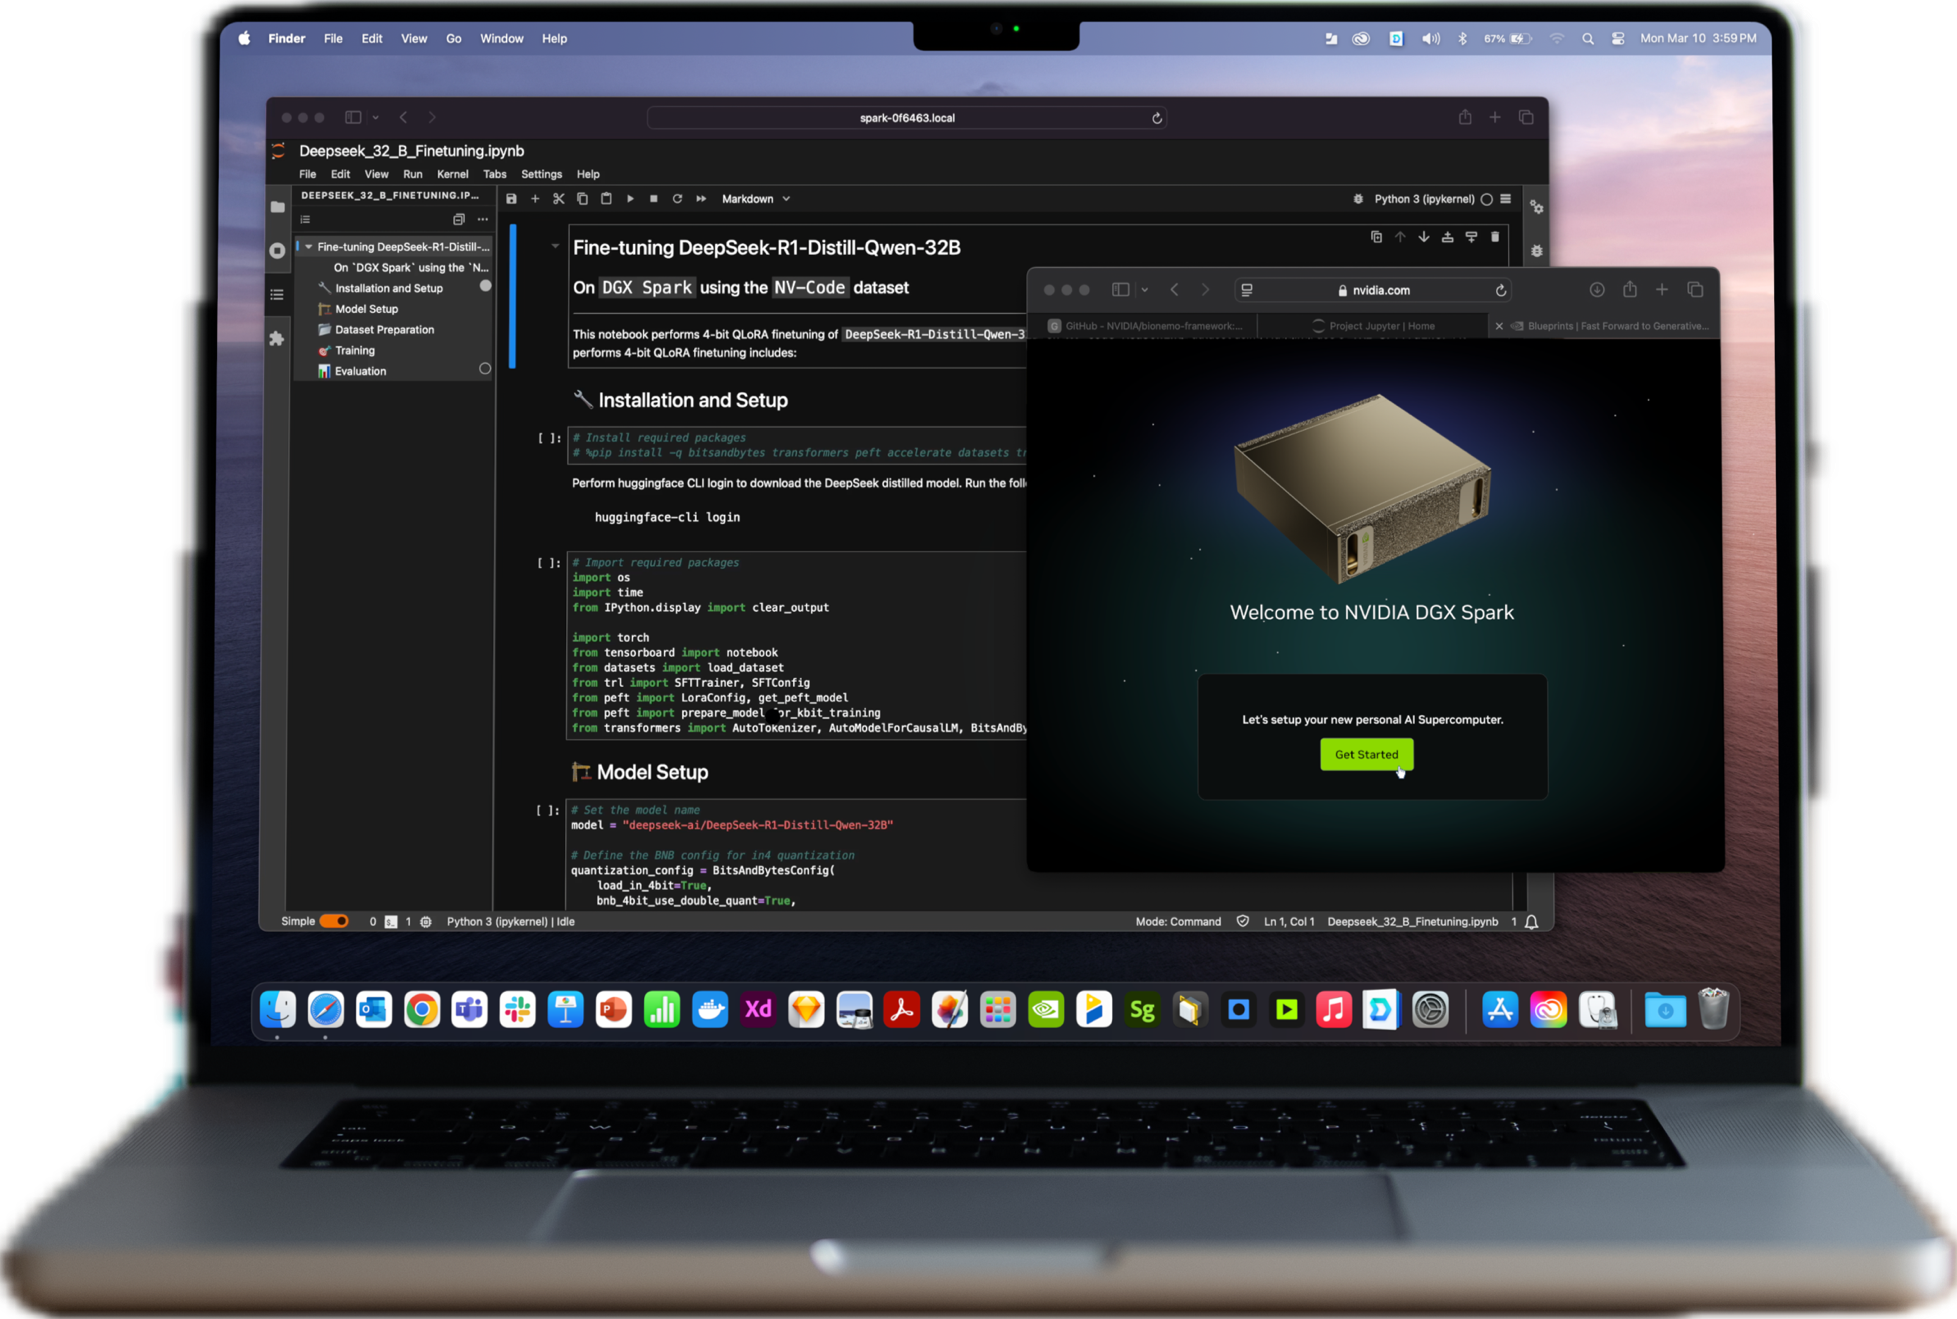
NVIDIA DGX Spark นำสถาปัตยกรรม Grace Blackwell มาสู่เดสก์ท็อป โดยออกแบบมาเฉพาะสำหรับนักพัฒนา AI นักวิจัย และนักวิทยาศาสตร์ด้านข้อมูล ช่วยให้คุณสามารถสร้างต้นแบบ ปรับแต่ง และประมวลผลโมเดลภาษาขนาดใหญ่ได้โดยไม่จำเป็นต้องส่งข้อมูลขึ้นคลาวด์
ชิปซูเปอร์ชิป GB10 รวมโปรเซสเซอร์ CPU แบบ Arm ที่มี 20 คอร์ เข้ากับหน่วยประมวลผลกราฟิก GPU แบบ Blackwell ที่มีเทนเซอร์โค้ร์รุ่นที่ 5 โดยเชื่อมต่อกันผ่านเทคโนโลยี NVLink-C2C ซึ่งรองรับหน่วยความจำแบบสอดคล้องกันระหว่าง CPU กับ GPU ด้วยหน่วยความจำแบบรวม (unified memory) ขนาด 128 กิกะไบต์ ผู้ใช้สามารถประมวลผลโมเดลที่มีพารามิเตอร์สูงสุดถึง 200,000 ล้านตัวบนอุปกรณ์เพียงหนึ่งเครื่อง และสามารถปรับขนาดขึ้นเป็น 405,000 ล้านตัวเมื่อใช้งานร่วมกับอุปกรณ์สองเครื่อง หรือสูงสุดถึง 700,000 ล้านตัวเมื่อใช้งานร่วมกับอุปกรณ์สี่เครื่อง โดยอาศัยระบบเครือข่าย ConnectX-7 ที่ติดตั้งมาในตัว
DGX Spark มาพร้อมระบบปฏิบัติการ NVIDIA DGX OS และซอฟต์แวร์ AI ที่ติดตั้งไว้ล่วงหน้า ซึ่งรองรับ PyTorch, TensorRT-LLM, Jupyter, Ollama, NVIDIA NIM และ NVIDIA Blueprints งานที่พัฒนาต้นแบบไว้ในท้องถิ่นสามารถย้ายไปยัง DGX Cloud หรือศูนย์ข้อมูลใด ๆ ที่ใช้เทคโนโลยีเร่งความเร็วจาก NVIDIA ได้โดยตรง
แอปพลิเคชันเป้าหมาย: การอนุมานโมเดลภาษาขนาดใหญ่ (LLM) แบบท้องถิ่น · การปรับแต่งโมเดล (fine-tuning) · การพัฒนาเอเจนต์ AI · วิทยาศาสตร์ข้อมูล · การพัฒนาต้นแบบ AI สำหรับขอบเครือข่าย (edge AI), หุ่นยนต์ และการมองเห็นด้วยคอมพิวเตอร์
ข้อมูลจำเพาะทางเทคนิค
ประเภทสินค้า |
ซูเปอร์คอมพิวเตอร์ AI NVIDIA DGX Spark (ระบบ Grace Blackwell แบบตั้งโต๊ะ) |
ชิปซูเปอร์ชิป |
ชิปซูเปอร์ชิป NVIDIA GB10 Grace Blackwell |
CPU |
cPU แบบ Arm 20 คอร์ (10 × Cortex-X925 + 10 × Cortex-A725) |
GPU |
หน่วยประมวลผลกราฟิกแบล็กเวลล์พร้อมคอร์เทนเซอร์รุ่นที่ 5 ให้ประสิทธิภาพสูงสุดถึง 1 พีเฟลอปที่ความแม่นยำ FP4 |
การเชื่อมต่อระหว่างซีพียูและจีพียู |
ลิงก์หน่วยความจำแบบสอดคล้อง NVLink-C2C |
หน่วยความจำ |
หน่วยความจำรวมแบบสอดคล้อง 128 กิกะไบต์ ใช้ LPDDR5x แบบ 256 บิต ที่ความเร็ว 273 กิกะไบต์ต่อวินาที |
ขนาดโมเดล |
รองรับโมเดลขนาดสูงสุด 200,000 ล้านพารามิเตอร์ต่อหนึ่งหน่วย; 405,000 ล้านพารามิเตอร์เมื่อใช้สองหน่วย; และสูงสุด 700,000 ล้านพารามิเตอร์เมื่อใช้สี่หน่วย |
การเก็บรักษา |
เอ็นวีเมมแบบ M.2 ความจุ 4 เทระไบต์ พร้อมระบบเข้ารหัสภายในตัว |
เครือข่าย |
เอ็นวีเดีย คอนเนกต์เอ็กซ์-7 (ความเร็ว 200 จิกะบิตต่อวินาที พร้อมพอร์ต QSFP จำนวน 2 ช่อง), อีเธอร์เน็ตความเร็ว 10 จิกะบิตต่อวินาที และไว-ไฟ 7 |
ระบบปฏิบัติการ |
เอ็นวีเดีย DGX OS |
ซอฟต์แวร์สำหรับปัญญาประดิษฐ์ |
ไพธอนทอร์ช, เทนเซอร์อาร์ท-แอลแอลเอ็ม, จูไพเตอร์, โอลามา, เอ็นวีเดีย นิม และเอ็นวีเดีย บลูพรินต์ ติดตั้งมาให้พร้อมใช้งาน |
เส้นทางการปรับใช้งาน |
ย้ายงานที่พัฒนาต้นแบบในท้องถิ่นไปยัง NVIDIA DGX Cloud หรือศูนย์ข้อมูลที่ใช้ GPU ของ NVIDIA ใดๆ ก็ตาม |
แหล่งจ่ายไฟ |
แหล่งจ่ายไฟภายนอกแบบเดี่ยว 240 วัตต์ |
ขนาด |
150 × 150 × 50.5 มิลลิเมตร |
น้ำหนัก |
1.2 กิโลกรัม |
แอปพลิเคชันเป้าหมาย |
การอนุมานโมเดลภาษาขนาดใหญ่ในท้องถิ่น การปรับแต่งโมเดลให้เหมาะสม การพัฒนาเอเจนต์ปัญญาประดิษฐ์ วิทยาศาสตร์ข้อมูล AI แบบขอบ (edge AI) หุ่นยนต์ และการพัฒนาต้นแบบการมองเห็นด้วยคอมพิวเตอร์ |