EN


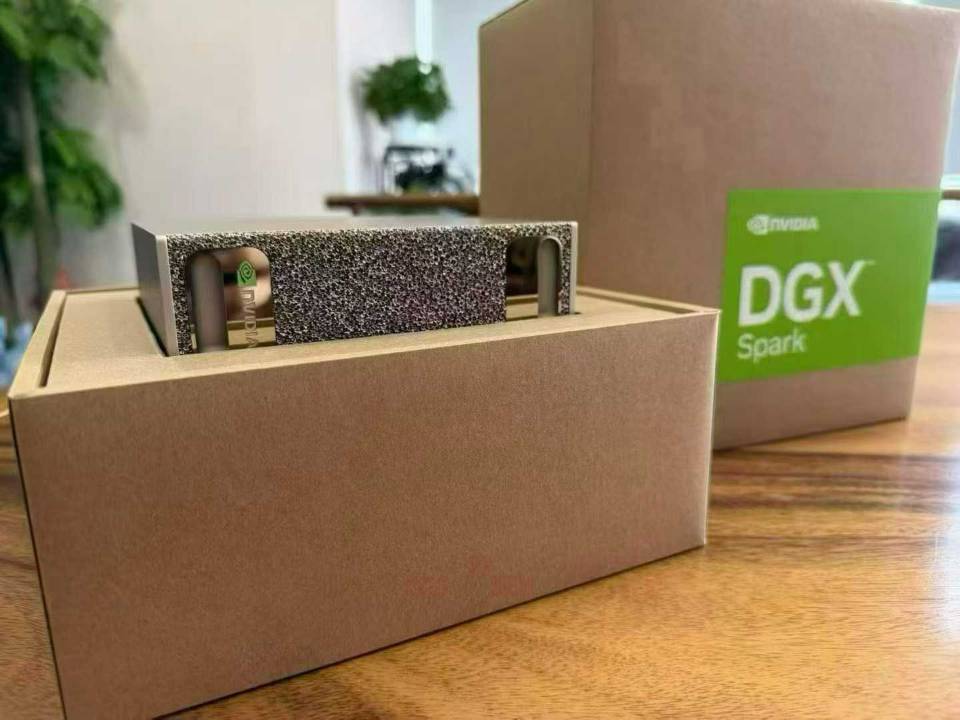
NVIDIA DGX Spark AI-Supercomputer — GB10 Grace Blackwell, 128 GB einheitlicher Arbeitsspeicher, 4 TB NVMe, 1 PFLOP FP4
Superchip: NVIDIA GB10 Grace-Blackwell-Superchip
CPU: 20-Kern-Arm-CPU (10× Cortex-X925 + 10× Cortex-A725)
GPU: Blackwell-GPU mit Tensor-Kernen der 5. Generation, bis zu 1 PFLOP bei FP4-Präzision
Erinnerung: 128 GB kohärenter einheitlicher Arbeitsspeicher, 256-Bit-LPDDR5x mit 273 GB/s
- Übersicht
- Empfohlene Produkte
Wichtige Merkmale
NVIDIA GB10 Grace Blackwell-Superchip — 20-Kern-Arm-CPU (10× Cortex-X925 + 10× Cortex-A725) gekoppelt mit einer Blackwell-GPU mit bis zu 1 PFLOP bei FP4-Präzision
128 GB kohärenter einheitlicher Arbeitsspeicher — 256-Bit-LPDDR5x mit 273 GB/s; Ausführen, Feinabstimmung und Bereitstellung von Modellen mit bis zu 200 Milliarden Parametern lokal
4-TB-NVMe-M.2-Speicher mit Selbstverschlüsselung, vorinstalliert mit NVIDIA DGX OS und dem vollständigen NVIDIA-KI-Software-Stack
Skalierung nach außen bei Bedarf – NVIDIA ConnectX-7-Netzwerk (200 Gb/s, 2× QSFP) sowie 10-GbE- und Wi-Fi-7-Unterstützung; Cluster aus bis zu 4 Einheiten für die Arbeit mit Modellen mit bis zu 700 Milliarden Parametern
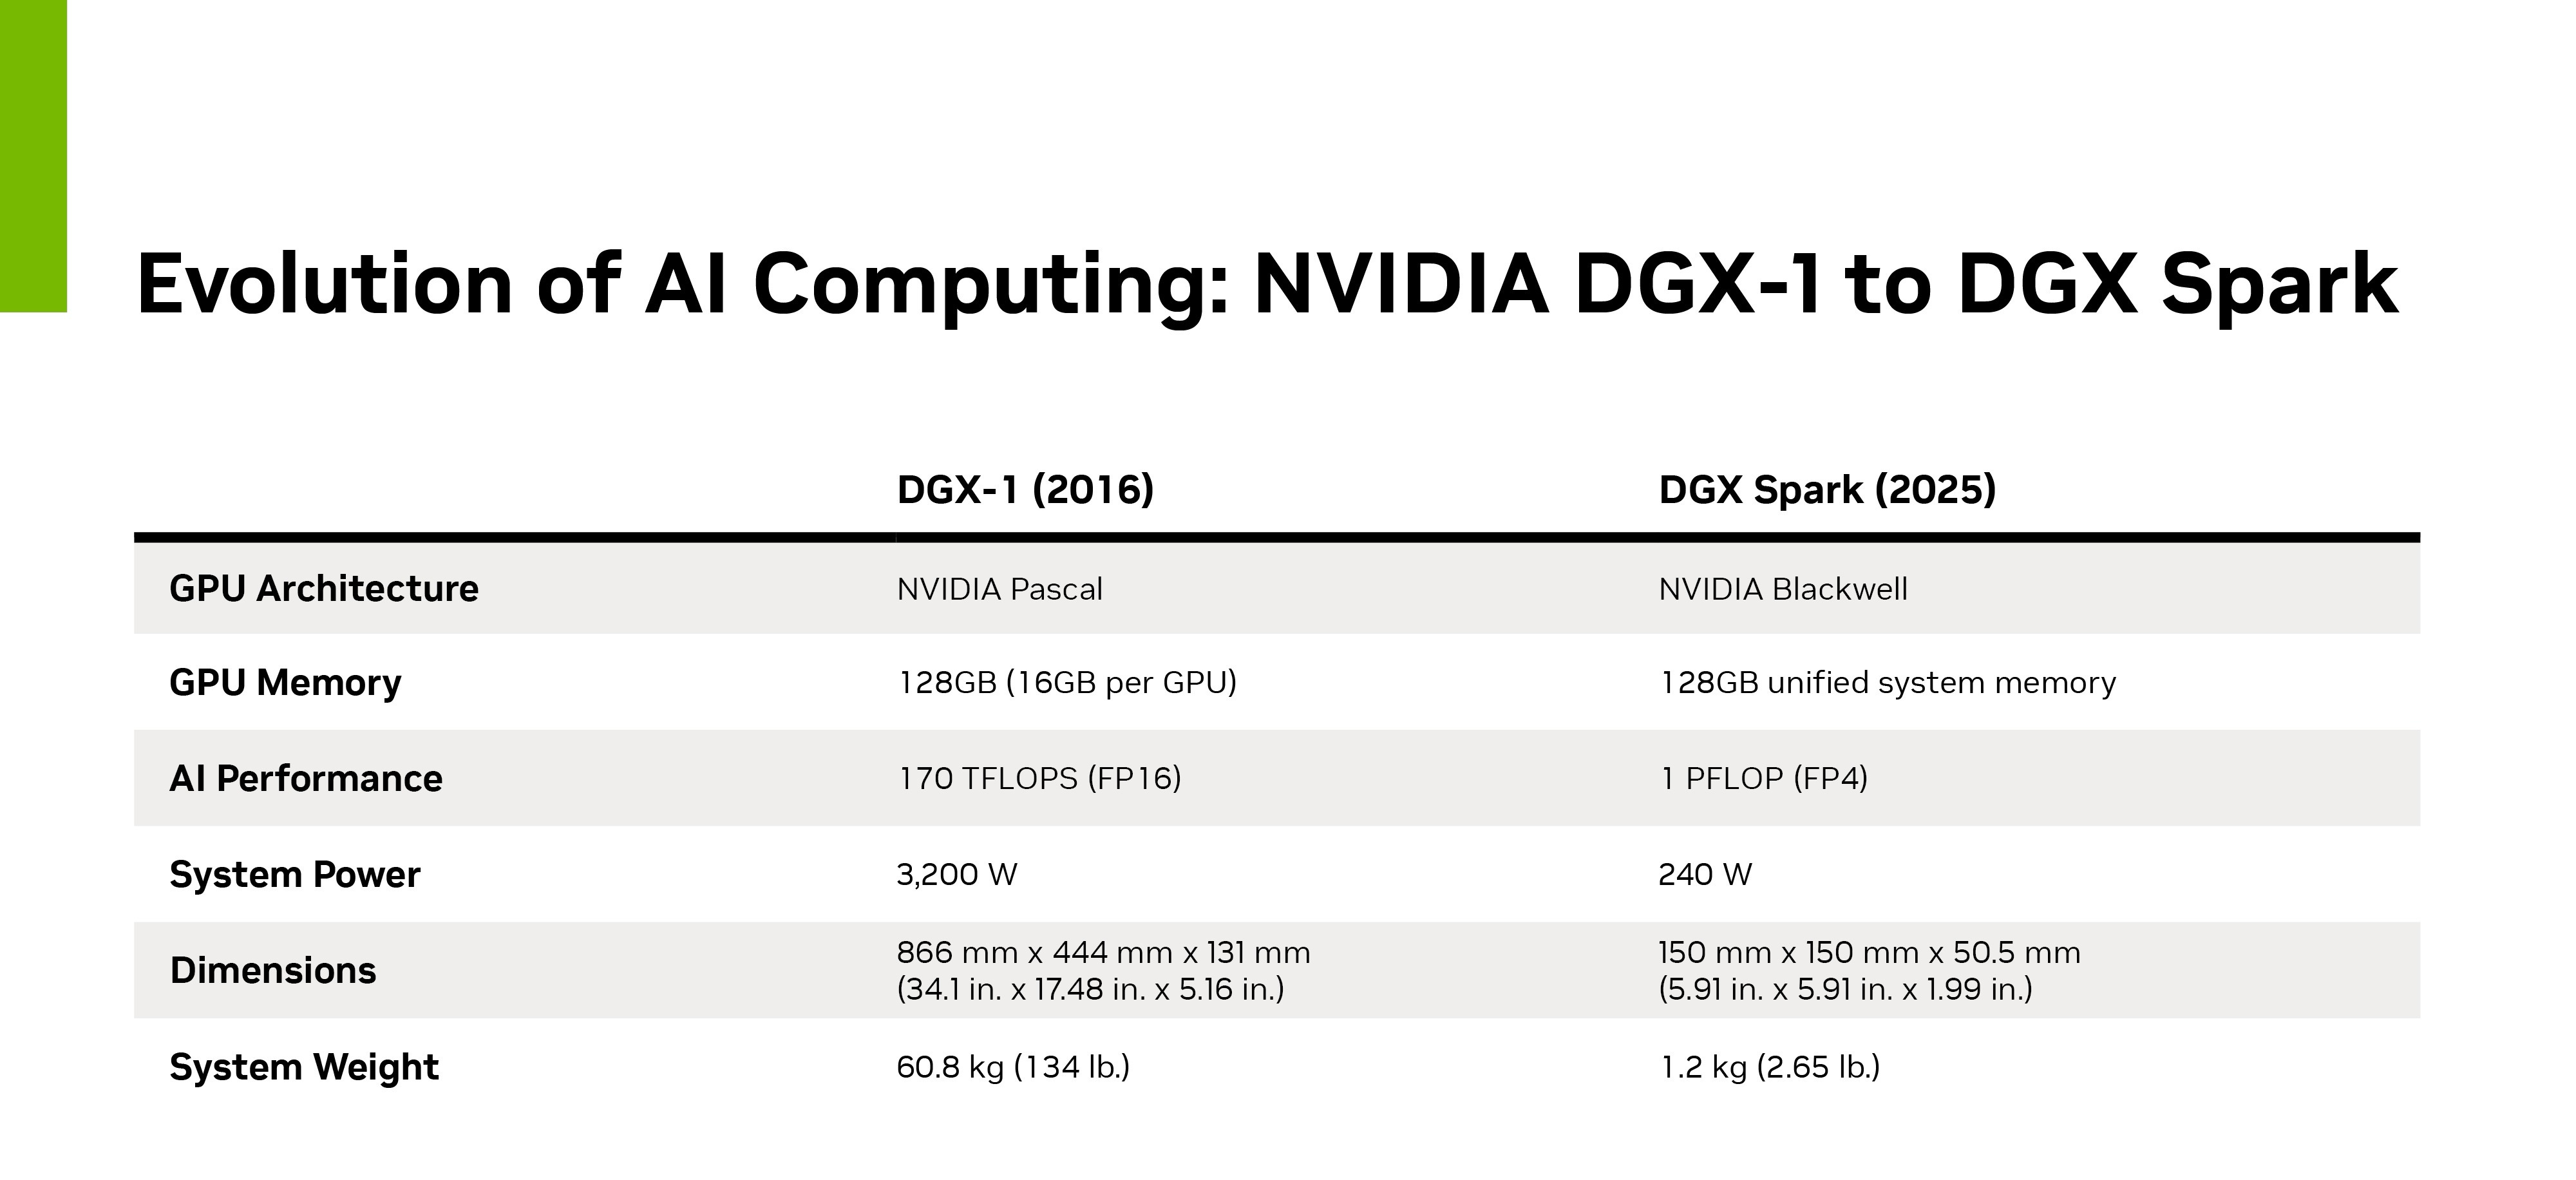
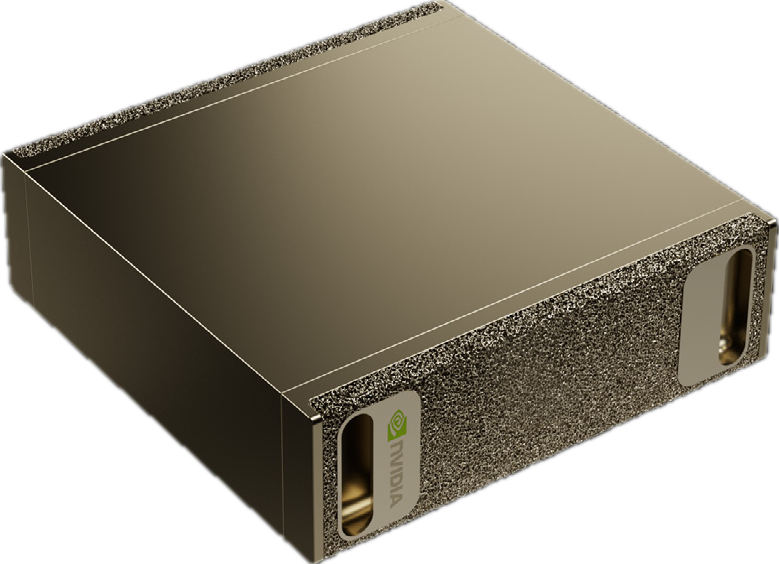
Echte Desktop-Größe – 150 × 150 × 50,5 mm, 1,2 kg, betrieben von einer einzigen externen 240-W-Stromversorgung
Beschreibung
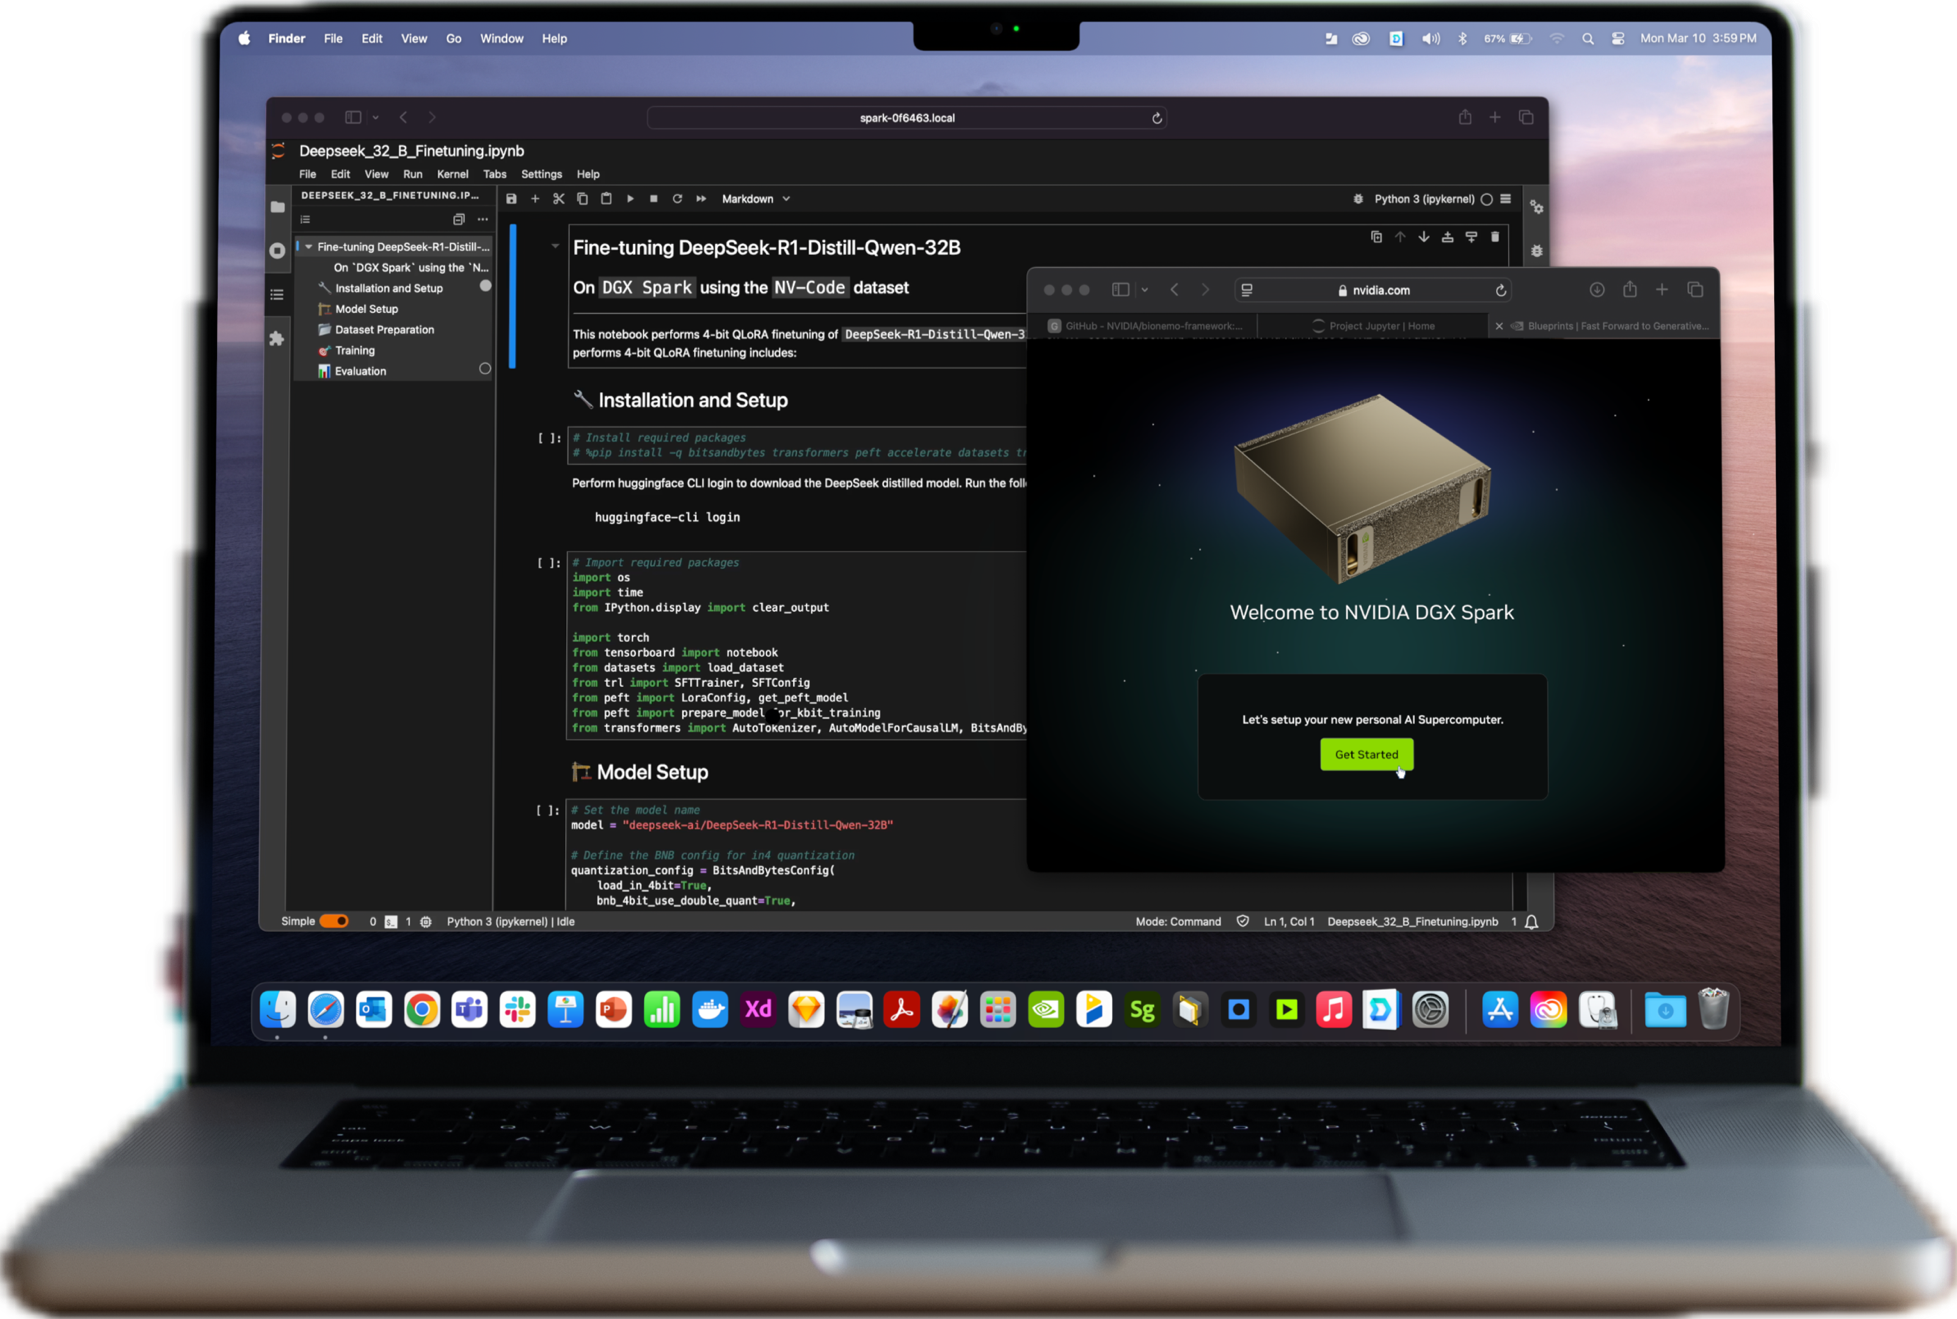
NVIDIA DGX Spark bringt die Grace-Blackwell-Architektur auf den Desktop. Entwickelt für KI-Entwickler, Forscher und Datenwissenschaftler ermöglicht es das Prototyping, die Feinabstimmung und die Inferenz großer Sprachmodelle – ohne dass Daten in die Cloud gesendet werden müssen.
Der GB10-Superchip kombiniert eine 20-Kern-Arm-CPU mit einer Blackwell-GPU mit Tensor-Kernen der fünften Generation und verbindet beide Komponenten über NVLink-C2C für kohärenten CPU+GPU-Speicher. Mit 128 GB einheitlichem Speicher können Sie Modelle mit bis zu 200 Milliarden Parametern auf einer einzigen Einheit verarbeiten und bei zwei Einheiten auf bis zu 405 Milliarden skalieren – oder bei vier Einheiten sogar auf bis zu 700 Milliarden – mithilfe des integrierten ConnectX-7-Netzwerks.
DGX Spark wird mit NVIDIA DGX OS und einem vorgeinstallierten KI-Softwarestack ausgeliefert, der Zugriff auf PyTorch, TensorRT-LLM, Jupyter, Ollama, NVIDIA NIM und NVIDIA Blueprints bietet. Lokal prototypisierte Arbeiten lassen sich direkt in die DGX Cloud oder jedes NVIDIA-beschleunigte Rechenzentrum übertragen.
Zielanwendungen: lokale LLM-Inferenz · Modell-Feinabstimmung · Entwicklung von KI-Agenten · Data Science · Edge-KI, Robotik und Prototyping im Bereich Computer Vision.
Technische Spezifikationen
Produkttyp |
NVIDIA DGX Spark KI-Supercomputer (desktopbasiertes Grace-Blackwell-System) |
Superchip |
NVIDIA GB10 Grace-Blackwell-Superchip |
CPU |
20-Kern-Arm-CPU (10× Cortex-X925 + 10× Cortex-A725) |
GPU |
Blackwell-GPU mit Tensor-Kernen der 5. Generation, bis zu 1 PFLOP bei FP4-Präzision |
CPU-GPU-Verbindung |
NVLink-C2C-kohärente Speicherverbindung |
Erinnerung |
128 GB kohärenter einheitlicher Arbeitsspeicher, 256-Bit-LPDDR5x mit 273 GB/s |
Modellgröße |
Bis zu 200 Milliarden Parameter auf einer Einheit; 405 Milliarden über zwei Einheiten; bis zu 700 Milliarden über vier Einheiten |
Lagerung |
4 TB NVMe M.2 mit Selbstverschlüsselung |
Netzwerkkonnektivität |
NVIDIA ConnectX-7 (200 Gb/s, 2× QSFP), 10-GbE- und Wi-Fi-7-Anschluss |
Betriebssystem |
NVIDIA DGX OS |
KI-Software-Stack |
PyTorch, TensorRT-LLM, Jupyter, Ollama, NVIDIA NIM und NVIDIA Blueprints, vorinstalliert |
Bereitstellungspfad |
Lokal prototypisierte Arbeit in die NVIDIA DGX Cloud oder ein beliebiges NVIDIA-beschleunigtes Rechenzentrum verschieben |
Stromversorgung |
Einzelne externe Stromversorgung mit 240 W |
Abmessungen |
150 × 150 × 50,5 mm |
Gewicht |
1,2 kg |
Zielanwendungen |
Lokale LLM-Inferenz, Modell-Feinabstimmung, Entwicklung von KI-Agenten, Datenwissenschaft, Edge-KI, Robotik und Prototyping für maschinelles Sehen |